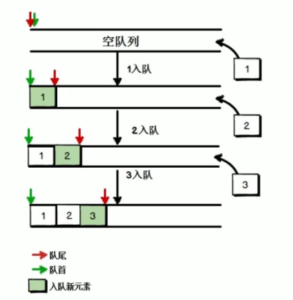
1.什么是栈?
栈(stack)是一种特殊的线性表,Linux内存中的栈空间就是基于此设计的,其栈底(第一个数据的位置bottom)是封闭的,栈的删除和写入只能在栈顶(栈的另一端top)进行。其遵循先进先出的原则(last input first output,LIFO)。
把数据插入到栈空间的动作称为入栈或者压栈,从栈空间删除数据的动作成为出栈或者弹栈。入栈与出栈遵循着先入先出的规范,具体我们可以看下面这题:
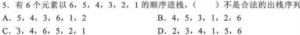
对于A选项,其在执行6入栈,5入栈,5出栈,4入栈,4出栈,3入栈,3出栈,6出栈,2入栈,1入栈,1出栈,2出栈后,可以得到符合要求的出栈序列。
对于B选项,其在执行6入栈,5入栈,4入栈,4出栈,5出栈,3入栈,3出栈,2入栈,1入栈,1出栈,2出栈,6出栈后,可以得到符合要求的出栈序列。
对于C选项,其在执行6入栈,5入栈,4入栈,3入栈,3出栈,4出栈之后,无法执行6出栈,因为当前还存在着5未出栈。
对于D选项,其在执行6入栈,5入栈,4入栈,3入栈,2入栈,2出栈,3出栈,4出栈,1入栈,1出栈,5出栈,6出栈后,可以得到符合要求的出栈序列。
通过上述具体的案例,我们可以了解到栈的原理以及数据读取方式,那么,栈的实现方式有哪些呢?通常情况下,我们在函数内部申明变量的时候,新的变量一般存储在栈空间里,但是如果我们自己想要模拟这种栈存储,可以考虑采用顺序表的形式进行,可以自由设计一些接口比如pop、push用于出栈与入栈。
若选用顺序表的形式来实现,那么栈顶在顺序表的尾部,栈底在顺序表的头部,这种情况下,栈顶指针指向顺序表的尾部,具体如下所示。
索引:  0     1     2     3
      [底]  [  ]  [  ]  [顶]  ← 栈顶指针指向 3(或 4,取决于实现)
如果采用链表的形式来实现,此时栈顶为链表的头部,在往栈内添加元素的时候,自动修改链表的头指针,并将新元素的next指针指向原本的第一个元素。
栈顶(头指针)→ [数据|next] → [数据|next] → [数据|null] ← 栈底由于链表的特性,采用链表模拟栈,可以无需设计栈的最大容量,但是缺点也很明显,其访问的时间复杂度为O(n),如果采用顺序表的形式来实现,则需设计顺序表的最大长度,从而设计栈的最大容量,但是其随机访问能力强,访问时间复杂度O(1),本文采用顺序表来实现,顺序表支撑文件的下载详见文章顺序表、链表及其C实现。
直接调用前面引用文章的sqlist.h中的函数,展开栈的示例。
#define DATA_TYPE int               //栈所需存储的数据类型
#define MAX_SIZE 100                //栈的最大数据设置

typedef struct _stack_t{
    Sqlist* data;
    int cnt;
} stack;

//创建栈,分配栈的单个数据占用空间
stack* stack_create();
//出栈
DATA_TYPE stack_pop(stack* st);
//入栈
bool stack_push(stack* st, DATA_TYPE push_data);
//读取栈中的某一个元素,从栈顶开始计数
DATA_TYPE stack_read(stack* st, int n);
//销毁栈
bool stack_des(stack** input_st);在使用中,通过调用上述函数,可以实现栈的创建、出栈、入栈以及销毁,同时可以通过调整DATA_TYPE与MAX_SIZE两个预定义宏,实现泛型栈。如需要源文件,请点击立即下载下载栈的有关操作文件

非特殊说明,本博所有文章均为博主原创。
如若转载,请注明出处:https://zixblog.com/zix/shujujiegou/zhandeyuanliyuyingyong/